Spring Boot 앱푸시 유량제어 구현: 학교별 5,000건 전송 시도 후 3분 쉬기
여러 학교의 앱푸시를 처리하는 데몬에 유량제어를 추가하면서, 처음에는 전송 반복문에 대기 한 줄을 넣으면 될 것처럼 보였다. 학교별로 대기 데이터를 읽고 중계 서버에 보내는 흐름은 이미 있었다. 여기에 “일정 건수를 보내면 잠깐 쉬기”만 더하면 된다고 생각하기 쉽다.
하지만 코드를 따라가니 대기의 위치보다 먼저 정해야 할 것이 많았다. DB에서 읽은 1,000건을 센 것인지, 중계 서버로 넘길 200건짜리 목록을 센 것인지, 실제 성공한 푸시만 센 것인지에 따라 전혀 다른 동작이 된다. A학교가 쉬는 동안 B학교도 기다리면 되는지도 중요한 조건이었다.
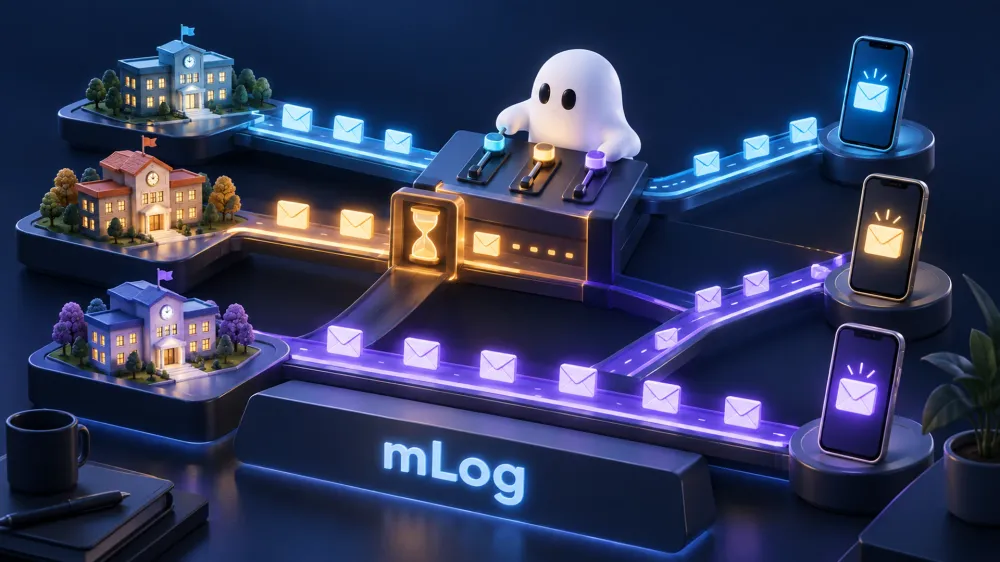
최종적으로 정리한 정책은 학교마다 전송 처리에 넘기는 메시지 수를 누적하고, 5,000건에 도달한 처리 호출이 끝난 뒤 다음 전송까지 3분을 확보하는 것이다. 한 번의 중계 요청은 최대 200건으로 나눴고, DB 조회 단위 1,000건은 별도로 유지했다.
이 글은 그 구현에서 무엇을 분리했고 어떤 문제를 더 발견했는지 정리한 기록이다. 예제는 업무 식별자를 제거해 재구성했으며 Java 17을 기준으로 한다. 학교별 제한 로직은 독립 예제로 검증하고, 실제 중계 API·DB·앱 수신까지 확인해야 하는 항목은 따로 남겼다. 운영 성능이 몇 배 좋아졌다거나 발송 누락이 모두 해결됐다는 결과를 전제로 하지 않는다.
목차
- 먼저 네 가지 숫자의 의미부터 나누기
- 10초 스케줄과 실제 전송 간격은 다르다
- 학교별 중복 실행과 스레드 풀 관리
- 카운터를 학교별로 유지해야 하는 이유
- 5,000건 경계를 넘지 않는 전송과 대기
- 알림 OFF 처리와 공유 캐시 분리
- 타임아웃·재시도·문자 대체 발송의 경계
- 3분 대기를 트랜잭션 밖에 두기
- 삭제하면서 OFFSET 페이지를 넘기면 생기는 일
- 학교별 제한으로 전체 부하까지 제어할 수 있을까
- 독립 예제로 검증한 것과 남은 검증
- 운영에 적용할 때 남겨야 할 기록
1. 먼저 네 가지 숫자의 의미부터 나누기
구현에서 가장 먼저 한 일은 “3분 대기”를 정확한 동작으로 바꾸는 것이었다. 대기 시간만 정하면 정책이 완성되는 것이 아니다. 누가, 무엇을, 몇 건 처리한 뒤, 언제부터 쉬는지를 함께 정해야 한다.
| 설정 | 이 구현에서의 의미 |
|---|---|
| DB 조회 1,000건 | 대기 테이블에서 한 번에 읽는 페이지 크기 |
| 전송 묶음 최대 200건 | 중계 API 한 번에 넘길 메시지 목록의 상한 |
| 학교별 누적 5,000건 | 휴식을 시작할 전송 시도 대상 수 |
| 3분·180초 | 경계에 도달한 처리 호출 종료 후 다음 전송까지의 최소 대기 |
여기서 5,000건은 HTTP 호출 5,000회가 아니다. 매번 200건을 채워 보낸다면 25번의 처리 호출로 도달한다. 마지막 묶음이 작거나 한도까지 남은 수가 적으면 호출 횟수는 달라질 수 있다.
알림이 꺼져 중계 서버에 보낼 필요가 없는 대상은 이 한도를 소비하지 않는다. 반대로 전송 처리에 넘긴 대상은 실패하거나 응답을 받지 못하더라도 한도에 포함한다. 성공한 수만 세면 장애가 난 학교가 같은 대상을 빠르게 재시도하며 오히려 부하를 키울 수 있기 때문이다.
다만 실제 계수 지점을 정확히 이해해야 한다. 현재 방식은 sendMessage 같은 전송 처리 메서드를 호출하기 직전에 목록 크기를 더한다. 그 메서드 안에서 사전 정보 조회가 실패해 HTTP 요청까지 도달하지 못해도 이미 예약한 건수는 되돌리지 않는다. 따라서 이 값은 중계 서버의 정확한 수신 건수가 아니라, 애플리케이션이 보수적으로 계산한 전송 처리 시도량이다.
또한 “5,000건 처리 후 3분 휴식”은 초당 일정량을 흘려보내는 정책과 다르다. 쉬기 전에는 5,000건이 짧은 시간에 몰릴 수 있다. 이 숫자를 FCM의 보편적인 권장 한도라고 해석해서도 안 된다. 학교별 업무 정책이며, 중계 서버와 외부 제공자의 제한은 별도로 확인해야 한다.
2. 10초 스케줄과 실제 전송 간격은 다르다
호출부의 스케줄은 다음 조건이었다.
@Scheduled(initialDelay = 60_000L, fixedRate = 10_000L)
public void dispatch() {
    // 학교 목록을 확인하고 비동기 작업을 제출한다.
}
애플리케이션 시작 후 최초 실행을 약 1분 늦추고, 이후 스케줄러가 정해진 주기로 호출부를 실행하도록 설정한 것이다. 이 메서드가 CompletableFuture.runAsync로 작업을 제출한 뒤 바로 반환한다면, 스케줄러가 관찰하는 완료는 제출 메서드의 반환이다. 실제 학교별 발송이 모두 끝났다는 뜻이 아니다.
따라서 fixedRate = 10_000을 보고 “학교마다 10초에 한 번만 전송한다”고 생각하면 안 된다. 학교 작업 하나가 내부에서 여러 페이지를 순회하고 여러 번 HTTP 요청을 보낼 수 있다. 그동안 다음 스케줄 호출도 도착할 수 있다.
Spring의 fixedDelay는 이전 스케줄 메서드 완료와 다음 실행 사이의 간격을 다룬다. 그러나 그 메서드가 비동기 작업만 제출하고 끝난다면 fixedDelay로 바꿔도 비동기 작업 전체 완료 뒤 대기가 되는 것은 아니다. 두 설정 모두 어떤 메서드의 시작·종료를 기준으로 하는지 확인해야 한다. Spring 스케줄링 공식 문서
여기에 처리 순회가 끝난 뒤 몇 초를 쉬는 데몬 루프가 별도로 있다면, 그것은 다시 다른 층의 대기다. 예를 들어 “전체 대상 순회 후 5초 대기”와 “5,000건 도달 후 180초 대기”를 함께 쓰더라도 앞의 것은 재조회 간격이고 뒤의 것은 학교별 전송 제한이다. 5초를 180초로 바꾸면 같은 기능이 된다고 볼 수 없다. 이번에 확인한 학교별 제한 코드에 5초 루프가 들어 있다고 가정하지 않고, 상위 호출부와 함께 구분해서 적용해야 한다.
3. 학교별 중복 실행과 스레드 풀 관리
비동기 실행에서는 A학교의 이전 작업이 끝나기 전에 A학교의 새 작업을 또 제출하는 문제부터 막아야 한다. 그렇다고 모든 학교를 서비스 전체 잠금 하나로 묶으면 A학교가 쉬는 동안 B학교도 처리하지 못한다.
호출부에는 실행 중인 작업을 processingServers라는 Set에 등록하고, 종료 시 제거하는 구조가 있었다. 학교별 제한을 설명하는 아래 예제에서는 실행권 키를 학교 식별자로 명확히 했다. 실제 호출부가 서버 단위로 학교 여러 곳을 묶는 구조라면 그 안의 순회와 실행권 범위도 함께 확인해야 한다. 이 패턴을 공개용으로 정리할 때는 다음 세 가지 조건을 명시하는 편이 좋다.
첫째, 동시 접근 가능한 Set을 사용한다. 둘째, “존재 여부 확인”과 “추가”를 두 단계로 나누지 않는다. 셋째, 작업 제출 자체가 실패해도 실행 중 표시를 지운다.
// 클래스 필드. 아래는 호출부 패턴을 보여주는 부분 예제다.
private final Set<String> runningSchools =
        ConcurrentHashMap.newKeySet();

// pushExecutor는 푸시 전용의 유한한 스레드 풀로 주입한다.
// submitSchool을 호출하는 반복문은 다음 학교도 계속 처리하도록 구성한다.
void submitSchool(String schoolId) {
    if (!runningSchools.add(schoolId)) {
        return;
    }

    try {
        CompletableFuture.runAsync(() -> {
            try {
                sendPushForSchool(schoolId);
            } finally {
                runningSchools.remove(schoolId);
            }
        }, pushExecutor).whenComplete((ignored, error) -> {
            if (error != null) {
                recordSchoolFailure(schoolId, error);
            }
        });
    } catch (RejectedExecutionException rejected) {
        runningSchools.remove(schoolId);
        recordSubmissionRejected(schoolId);
    }
}
위의 sendPushForSchool, 기록 메서드와 pushExecutor는 프로젝트가 제공해야 하는 협력 객체다. 그대로 붙이면 모든 연계가 끝나는 전체 서비스 코드라는 의미는 아니다. 예외 기록에는 실패 종류와 작업 식별자만 남기고, 요청 본문·기기 토큰·인증 헤더가 섞인 예외 메시지를 그대로 공개하지 않는다.
contains()가 false인 것을 확인한 두 스레드가 각각 add()를 실행하면 둘 다 일을 시작할 수 있다. 반면 동시성 Set의 add() 결과로 실행권을 결정하면 확인과 등록을 하나의 원자적 연산으로 다룰 수 있다. Java 17 ConcurrentHashMap API
또 하나의 함정은 거절 정책이다. 작업을 조용히 버리는 정책이면 Runnable의 finally가 실행되지 않아 학교가 영원히 실행 중으로 남을 수 있다. 위 예제는 거절 시 예외가 발생하는 정책을 전제로 한다. 종료 중인 풀에 제출하는 경우도 함께 확인한다.
실행기를 지정하지 않은 CompletableFuture.runAsync는 기본적으로 공용 ForkJoinPool을 사용한다. HTTP 대기와 3분 휴식이 있는 작업을 다른 비동기 기능과 같은 풀에서 처리하면 서로 영향을 줄 수 있다. 푸시 전용 풀, 유한한 작업 대기열, 제출 거절 감지를 함께 설계하는 이유다. Java 17 CompletableFuture API
학교별 실행 중 표시는 큐에 들어간 시점부터 작업이 끝날 때까지 유지된다. 실행 전 큐에서 제거되어 앞으로 시작하지 않을 것이 확정된 작업은 별도로 표시를 정리해야 한다. 작업 본문이 시작되기도 전에 사라진 작업에는 본문의 finally를 기대할 수 없기 때문이다. 이미 실행 중인 작업은 취소 요청만으로 표시를 지우지 않고, 실제 작업이 끝나는 finally에서 해제한다.
4. 카운터를 학교별로 유지해야 하는 이유
중복 실행을 막는 Set과 유량제어 상태는 목적과 수명이 다르다. Set은 지금 실행 중인지를 나타낸다. 유량제어 상태는 지금까지 몇 건을 시도했고, 다음 전송까지 얼마나 더 쉬어야 하는지를 기억한다.
예를 들어 A학교가 이번 실행에서 3,000건을 처리한 뒤 종료하고 다음 실행에서 2,000건을 더 처리했다면, 같은 서비스 인스턴스 안에서는 총 5,000건에 도달한 것으로 본다. 메서드 안의 지역 변수로 매번 카운터를 0으로 만들면 두 실행 모두 한도에 도달하지 않는다.
반대로 모든 학교가 같은 카운터를 사용하면 A학교가 처리한 4,900건 때문에 B학교는 100건만 보내고 쉬게 된다. 학교별 독립 제한이라는 요구와 맞지 않는다.
// 학교 식별자별로 카운터와 휴식 상태를 유지한다.
private final ConcurrentMap<String, SchoolState> states =
        new ConcurrentHashMap<>();

// 같은 학교의 상태를 갱신할 때는 같은 잠금을 사용한다.
SchoolState state = states.computeIfAbsent(
        schoolId, ignored -> new SchoolState());

synchronized (state) {
    // 남은 한도 확인 → 수량 확보 → 전송 → 휴식 상태 기록
}
최종 서비스 코드는 위와 같은 학교별 상태 잠금을 사용했다. 같은 학교는 직렬로 처리하고 다른 학교의 상태에는 별도 잠금을 둔다. 호출부의 Set은 같은 학교 작업을 계속 쌓지 않게 하고, 서비스의 잠금은 누적량을 동시에 갱신하지 않게 한다. 둘 중 하나가 있다고 다른 쪽의 역할까지 자동으로 충족하는 것은 아니다.
단, synchronized 잠금을 기다리는 동안에는 interrupt만으로 즉시 빠져나올 수 없다. 이 글에 함께 제공하는 독립 예제는 중단 가능한 잠금 획득을 보여주기 위해 ReentrantLock.lockInterruptibly()로 재구성했다. 이는 기존 서비스 전체를 교체한 운영 결과가 아니라 예제의 개선점이다.
작업이 끝났다고 states.remove(schoolId)를 호출하지 않는 것도 중요하다. 아직 5,000건에 못 미친 누적량이나 진행 중인 휴식 상태를 잃을 수 있다. 학교 삭제·장기 미사용 상태 정리가 필요하다면 실행권과 휴식 상태를 함께 검토한 별도 수명 정책으로 처리한다.
5. 5,000건 경계를 넘지 않는 전송과 대기
한 번에 최대 200건씩 보낸다고 해도 마지막 요청이 5,000건을 넘기지 않도록 잘라야 한다. 계산은 세 값 중 가장 작은 수를 고르는 방식이다.
int batchSize = Math.min(
        200,
        Math.min(remainingItems, 5_000 - attemptedCount));
한도에 도달한 상태에서는 이 계산 전에 남은 휴식부터 처리하고 카운터를 초기화한다. 그렇지 않으면 크기 0인 묶음이 만들어져 진행하지 못하는 반복문이 될 수 있다.
누적 4,800건인 A학교에 새 대상 500건이 들어왔다면 다음과 같이 동작한다.
- 200건을 처리 호출에 넘기기 전에 누적을 5,000건으로 올린다.
- 그 호출이 정상 반환하거나 예외로 끝나면 휴식 시작 시간을 기록한다.
- 남은 300건을 보내기 전에 휴식 잔여 시간을 기다린다.
- 180초가 지나면 누적을 0으로 초기화한다.
- 남은 300건은 200건과 100건으로 처리한다.
그 결과 이번 입력의 전송 묶음은 200 → 휴식 → 200 → 100이다. 누적 4,950건이었다면 처음에는 50건만 넘기고 쉬어야 한다. “항상 200개씩”이라는 분할 규칙보다 누적 한도를 지키는 것이 먼저다.
독립 예제의 핵심도 이 순서를 따른다.
// 같은 학교의 잠금을 보유한 상태에서 실행하는 핵심 흐름이다.
awaitAvailableWindow(state);

int size = Math.min(BATCH_LIMIT,
        Math.min(recipients.size() - offset,
                SCHOOL_ATTEMPT_LIMIT - state.attempted));
List<T> batch = List.copyOf(recipients.subList(offset, offset + size));

state.attempted += size;  // 처리 호출 전에 한도를 예약한다.
boolean boundary = state.attempted == SCHOOL_ATTEMPT_LIMIT;
try {
    sender.send(batch);  // 동기 호출: 여기서 반환할 때 해당 처리가 끝나야 한다.
} finally {
    if (boundary) {
        state.cooldownStartedNanos = clock.nanoTime();
    }
}
offset += size;
위 코드는 정책을 보여주는 발췌다. 실제 파일에는 학교별 잠금, 입력 검사, 중단 처리, 남은 휴식 계산이 함께 들어 있다. sender가 Future만 반환하고 실제 전송은 나중에 끝내는 식으로 동작하면 휴식 시작 시점이 달라진다. 이 계약은 반드시 동기 완료 기준으로 맞춰야 한다.
휴식 시작 시점도 세밀하게 봐야 한다. 기존 sendMessage는 HTTP 통신만 하는 메서드가 아니었다. 결과 이력과 대기 데이터 처리도 포함되어 있었다. 따라서 휴식 기점은 HTTP 응답을 받은 순간이 아니라 그 처리 호출의 반환 또는 예외 종료 시점이다. Spring 프록시를 통해 트랜잭션이 적용됐다면 종료 과정의 커밋·롤백도 영향을 준다.
시간 측정은 경과 시간을 위한 System.nanoTime()을 사용한다. 현재 시각에서 날짜를 더하는 방식과 달리 시스템 시각 보정에 좌우되지 않도록 경과량의 차이를 계산할 수 있다. 이 값은 사람이 읽는 일시가 아니며 DB에 저장해 다른 JVM이나 재시작 뒤에도 같은 기준으로 쓰는 값이 아니다. Java 17 System.nanoTime API
마지막 묶음에서 정확히 5,000건이 되었지만 더 보낼 대상이 없다면, 즉시 3분 동안 붙잡고 있을 필요는 없다. 휴식 시작만 기록하고 반환해도 된다. 다음 호출이 60초 뒤에 오면 약 120초만 더 쉬고, 180초 이후라면 바로 누적을 초기화해 재개한다.
한도에 못 미친 채 오래 유휴 상태였다고 카운터를 자동으로 초기화하지는 않는다. 그것까지 원한다면 “마지막 전송 후 일정 시간 동안 조용하면 새 주기로 본다”는 별도 정책이 필요하다. 지금의 정책은 시간창 기반 제한이 아니라 누적량 도달 후 휴식이다.
6. 알림 OFF 처리와 공유 캐시 분리
전송량을 세기 전에 실제 중계 전송이 필요한 대상부터 나눠야 한다. 알림 OFF 대상은 이력 처리와 대기 데이터 정리가 필요할 수 있지만, 중계 API로 보내지는 않으므로 전송 한도에서 제외한다.
List<PushItem> sendable = new ArrayList<>();
List<PushItem> disabled = new ArrayList<>();

for (PushItem item : pageItems) {
    if (item.notificationEnabled()) {
        sendable.add(item);
    } else {
        disabled.add(item);
    }
}

// 업무 정책에 맞는 별도 이력 처리. 실제 발송 성공과 구분한다.
recordSkippedNotifications(disabled);
limiter.sendEligible(schoolId, sendable, sender);
기존 서비스에서는 OFF 대상을 SUCCESS 상태와 Alarm OFF 설명으로 기록했다. 그 체계를 그대로 집계하면 알림을 보내지 않은 건도 성공 건수에 포함될 수 있다. 상태 코드를 바로 바꾸기 어렵더라도 처리 완료 수와 실제 발송 성공 수를 보고서에서 구분해야 한다. 앞으로 상태를 설계한다면 SKIPPED_DISABLED처럼 원인을 드러내는 구분을 고려할 수 있다.
병렬 처리에서 별도로 점검한 부분은 메시지 조회 캐시였다. 기존에는 서비스 필드의 ConcurrentHashMap에 메시지 정보를 보관하고 clearMap()에서 전체를 비웠다. 학교별 작업이 동시에 실행되면 A학교가 아직 사용 중인 캐시를 B학교가 정리할 수 있는 구조다.
ConcurrentHashMap을 썼다는 사실은 개별 Map 연산의 동시성 안전성을 뜻한다. 작업마다 필요한 캐시의 수명이 서로 독립적이라는 뜻은 아니다. 전체 삭제와 조회가 겹친다고 무조건 잘못된 메시지가 발송됐다고 단정할 수는 없지만, 캐시 적중률·재조회 시점·업무상 일관성을 예측하기 어려워진다.
그래서 목록 변환 메서드 안에서 지역 Map을 만드는 구조로 바꿨다.
List<PushItem> convertPage(List<WaitingItem> items) {
    Map<String, MessageDefinition> cache = new HashMap<>();
    List<PushItem> result = new ArrayList<>(items.size());

    for (WaitingItem item : items) {
        MessageDefinition message = cache.computeIfAbsent(
                item.messageId(), this::loadMessage);
        PushItem converted = convert(item, message);
        if (converted != null) {
            result.add(converted);
        }
    }
    return result;
}
이 예제는 한 호출이 목록을 순차 변환한다는 전제다. Map을 다른 스레드로 넘기지 않으므로 HashMap으로 충분하다. 변환이 끝나면 캐시도 더 이상 다른 호출에 재사용되지 않는다. 반환 객체가 참조하는 메시지 데이터까지 즉시 해제된다는 뜻은 아니다.
학교별로 같은 메시지 번호를 사용할 수 있다면 캐시 키의 유일성도 검토해야 한다. 지역 캐시라고 해서 잘못된 조회 키가 해결되지는 않는다. 여러 학교를 한 번에 변환하는 메서드라면 (schoolId, messageId)처럼 실제 유일성에 맞는 키가 필요하다.
7. 타임아웃·재시도·문자 대체 발송의 경계
확인한 중계 호출 코드는 RestTemplate 연결 타임아웃 3초, 읽기 타임아웃 7초를 사용했다. 이는 해당 코드의 설정이며 모든 푸시 환경에 권장하는 값은 아니다. 두 값을 단순히 더해서 “작업이 무조건 10초 안에 끝난다”고 설명할 수도 없다. 클라이언트 구현과 연결 풀, 요청 처리 과정, 중계 서버 내부 작업을 함께 봐야 한다.
응답을 받지 못했을 때 가장 중요한 질문은 “정말 발송되지 않았는가?”이다. 중계 서버가 이미 메시지를 접수하거나 외부 푸시 서비스로 넘긴 뒤 응답만 늦어질 수도 있다. 그러므로 읽기 타임아웃을 확정적인 미발송으로 처리하고 즉시 재시도하면 중복 알림이 발생할 수 있다.
유량 한도에 실패·타임아웃을 포함하는 이유가 여기에 있다. 다만 한도를 센다는 것만으로 중복 발송이 해결되는 것은 아니다. 재시도 시 같은 논리적 메시지를 식별할 키, 중계 서버의 중복 요청 처리 계약, 처리 상태를 조회할 방법이 별도로 필요하다.
예를 들어 (학교, 알림 이벤트, 수신 대상)을 조합한 식별자를 처음 시도부터 재시도까지 유지하는 방안을 검토할 수 있다. 이 키를 헤더 하나에 추가했다고 자동으로 멱등성이 생기지는 않는다. 중계 서버가 원자적으로 키를 기록하고, 같은 키의 재호출에 기존 결과를 어떻게 돌려줄지 정의해야 한다.
중계 응답도 전체 HTTP 상태만으로 끝내지 않는다. 응답 본문이 있는지, 결과 목록 수가 요청 대상 수와 같은지, 결과 순서가 보장되는지 확인해야 한다. 순서 계약이 없다면 요청 식별자 기준으로 매칭해야 한다. 일부 성공과 전체 실패를 같은 경로로 처리하면 정상 처리된 대상까지 재시도할 수 있다.
검토한 코드에는 결과별 실패 처리와 통신 예외 처리에서 재시도 경계 조건이 각각 >=와 >로 다른 부분도 있었다. 변수의 의미가 “총 시도 횟수”인지 “최초 시도 이후 재시도 횟수”인지 먼저 결정해야 한다. 같은 3이라는 설정으로 한쪽은 세 번째에 종료하고 다른 쪽은 네 번째에 종료한다면 운영자가 기대하는 정책과 달라질 수 있다. 이 글에서 실제 재시도 횟수 정책을 확정해 덮어쓰지는 않는다.
푸시 실패 뒤 SMS를 보내는 경우도 마찬가지다. 앱푸시가 이미 접수됐는데 응답만 잃었다면 사용자는 푸시와 문자를 둘 다 받을 수 있다. 비용·수신 동의·중복 알림 정책이 연결되므로 “타임아웃이면 바로 문자”를 일반적인 정답으로 삼지 않는다.
FCM의 재시도 정책 역시 고정 3분 휴식과 별개다. 제공자가 429나 503 및 Retry-After를 돌려주는 경우 응답에 맞는 대기와 백오프가 필요하다. 애플리케이션이 FCM을 직접 호출하지 않고 자체 중계를 거친다면 중계가 이 정보를 어떻게 전달하는지도 계약에 포함한다. FCM 오류 코드
일괄 휴식만으로 짧은 순간의 폭주가 없어지는 것도 아니다. 필요하면 전송 묶음 사이의 속도 제한, 재시도 백오프와 지터, 학교별 휴식 시간을 함께 적용한다. Firebase도 급격한 트래픽 증가와 재시도 집중을 완화할 것을 안내한다. FCM 대규모 전송 가이드
마지막으로 FCM에서 메시지 ID를 받는 것과 사용자의 단말에서 알림이 표시되는 것은 다르다. 사업 지표의 성공 기준도 중계 접수, 제공자 접수, 단말 수신, 사용자 확인 중 무엇인지 명시해야 한다. FCM 메시지 수명과 전달 동작
8. 3분 대기를 트랜잭션 밖에 두기
학교별 상태를 잘 나눠도 3분 동안 DB 연결과 잠금을 잡고 있으면 다른 문제가 생긴다. 대기 코드를 전송 메서드 바깥에 뒀다는 사실만으로 충분하지 않다. 상위에서 호출한 배치 Step이나 서비스가 이미 트랜잭션을 열어 둔 것은 아닌지 확인해야 한다.
확인한 전송 메서드에는 REQUIRES_NEW가 있었다. 이 설정은 적용되는 프록시 호출에서 독립된 물리 트랜잭션을 사용하도록 한다. 바깥 트랜잭션이 존재한다면 일시 중단될 수 있고, 그 트랜잭션이 이미 확보한 연결 등 자원은 남을 수 있다. 내부 트랜잭션이 추가 연결을 요구하므로 풀 고갈도 고려해야 한다. Spring 트랜잭션 전파 공식 문서
기존 코드는 HTTP 호출과 결과 DB 변경이 같은 전송 메서드에 들어 있었다. 이후 설계를 다듬을 때는 다음처럼 책임을 나눌 수 있다.
- 짧은 트랜잭션으로 이번에 처리할 대상을 확보한다.
- 트랜잭션을 끝내고 유량 제한과 외부 호출을 처리한다.
- 짧은 트랜잭션으로 결과와 다음 시도 시각을 기록한다.
이 구조에도 보완이 필요하다. 첫 단계에서 대상을 확보한 뒤 프로세스가 종료되면 누가 다시 처리할지, 확보의 유효기간은 얼마인지, 외부 호출 후 결과 저장에 실패하면 어떻게 복구할지 정의해야 한다. 트랜잭션을 짧게 나눴다고 분산 환경의 정합성이 자동으로 완성되지는 않는다.
반대로 DB 트랜잭션을 외부 호출까지 길게 유지하더라도 외부 전송은 함께 롤백되지 않는다. 중계 서버는 접수했는데 이력 저장이 실패해 DB만 롤백되면 같은 대상이 다시 조회될 수 있다. 이때 필요한 것은 “HTTP까지 하나의 DB 트랜잭션으로 되돌리기”가 아니라 상태 전이·재조회·멱등 처리의 설계다.
Spring의 일반적인 프록시 기반 트랜잭션은 호출 경계도 중요하다. 같은 객체 안에서 메서드를 직접 부르는 경우에는 기대한 어노테이션이 적용되지 않을 수 있다. 비동기 스레드로 현재 스레드의 트랜잭션이 자동 전파되는 것으로 가정하지도 않는다. Spring 선언적 트랜잭션 적용
9. 삭제하면서 OFFSET 페이지를 넘기면 생기는 일
유량제어를 붙이면서 남은 중요한 문제는 페이지 조회였다. 현재 저장된 데몬 코드는 PageRequest로 읽고 nextPageable()로 다음 페이지를 조회한다. 그런데 전송 처리에서는 성공한 대기 행을 삭제한다.
고정된 목록을 조회할 때와 달리, 처리하는 동안 목록 자체가 줄어드는 것이다. 다음은 동작을 설명하기 위해 번호가 연속적이고 같은 정렬로 조회된다고 가정한 예다.
처음 대기 데이터가 1번부터 3,000번까지 있다. 첫 페이지에서 1번부터 1,000번까지 처리한 뒤 삭제하면 남은 것은 1,001번부터 3,000번까지다. 여기서 다음 페이지라며 OFFSET 1000으로 조회하면 현재 남은 목록의 앞 1,000개를 건너뛴다. 다음 결과는 2,001번부터 시작하고, 1,001번부터 2,000번까지는 이번 순회에서 빠진다.
이것은 그 행이 DB에서 사라졌다는 의미가 아니다. 다음 데몬 순회에서 다시 잡힐 수 있지만 이번 순회의 처리 지연이나 남은 건수와 종료 판단의 불일치가 생길 수 있다. 최종 유량제어 코드에도 이 페이징 문제는 남아 있었으므로 해결 완료로 기록하지 않았다.
PostgreSQL의 OFFSET은 결과의 앞부분을 건너뛰는 기능이다. 페이지 간 일관된 순서에는 유일한 정렬 기준이 필요하지만, 정렬을 추가하는 것만으로 삭제에 따른 위치 이동이 없어지지는 않는다. PostgreSQL LIMIT·OFFSET 문서
“그럼 계속 0페이지만 읽으면 되지 않을까?”라는 대안도 신중해야 한다. 첫 페이지에 예약 시간이 안 된 대상이나 제외 대상이 남아 있으면 뒤로 진행하지 못할 수 있다. 재시도 대상이 즉시 같은 조건으로 다시 잡히면 오류 행을 계속 두드리는 반복문이 되기도 한다.
한 번의 순회를 안정적인 키 기준으로 진행하는 키셋 조회는 검토할 수 있는 대안이다. 아래는 실제 업무 테이블이 아닌 설명용 SQL이다.
SELECT id, school_id, message_id
FROM push_wait
WHERE school_id = :school_id
  AND id > :last_seen_id
  AND id <= :run_upper_id
  AND status = 'READY'
  AND next_attempt_at <= :now
ORDER BY id
LIMIT 1000;
이 예제는 id가 유일하고 안정적인 정렬 키라는 가정이 있다. 실행 시작 때 상한을 잡아 새로 추가되는 행 때문에 순회가 끝없이 늘어나는 것을 방지하는 방식도 고려했다. 실제로는 복합 키, 예약 시각, 상태 인덱스와 데이터량에 맞춰 쿼리를 설계해야 한다.
커서는 이번에 조회한 마지막 키를 기준으로 전진시키고, 실패한 대상은 다음 시도 시각을 기록해 다음 순회에서 처리하도록 설계할 수 있다. 이전 커서보다 작은 행이 뒤늦게 커밋되거나 다시 READY가 되는 경우도 다음 순회가 다시 찾을 수 있어야 한다. 키셋 조회는 그 자체로 작업 소유권을 확보하거나 중복 발송을 막는 기능이 아니다.
여러 서버가 대기열을 함께 소비한다면 작업 선점도 별도로 필요하다. PostgreSQL의 FOR UPDATE SKIP LOCKED는 큐 형태 테이블에서 잠긴 행을 건너뛰는 데 활용할 수 있다. 다만 일관된 전체 조회를 보장하는 기능이 아니며, 짧게 선점·상태 변경 후 커밋하고 외부 호출을 수행하는 방식과 복구 정책을 함께 설계해야 한다. PostgreSQL SELECT 잠금 절
10. 학교별 제한으로 전체 부하까지 제어할 수 있을까
A학교가 3분 쉬는 동안 B학교가 독립적으로 진행할 수 있도록 상태를 나눴다. 하지만 “독립적으로 진행할 수 있다”와 “항상 즉시 실행된다”는 다르다. 실행할 스레드가 모두 다른 학교의 대기에 묶여 있으면 B학교도 큐에서 기다린다.
지금의 대기 방식은 실행 스레드를 점유한다. 학교 수가 적고 전용 풀에 충분한 여유가 있다면 이해하기 쉬운 구현이지만, 학교가 늘어나면 휴식 중인 작업의 비율을 봐야 한다. 풀 크기만 크게 늘리면 HTTP 연결·DB 연결·중계 서버 동시 처리량이 다음 병목이 될 수 있다.
다음 단계로는 학교별 nextEligibleAt을 기록하고 작업을 반환한 뒤, 다시 보낼 시각이 된 학교만 제출하는 방식을 검토할 수 있다. 다만 10초 주기로 확인한다면 실제 재개는 180초보다 늦어질 수 있다. 최소 대기 요구에는 맞아도 정확히 180초 뒤 재개하는 스케줄은 아니다.
그 구조로 바꿀 때는 메모리에서 기다리던 대상 목록을 어떻게 다룰지, DB에서 다시 조회할지, 선점한 작업을 어떻게 유지하거나 돌려놓을지도 함께 설계해야 한다. sleep을 지우고 return만 넣는 것으로 같은 동작이 유지되지는 않는다.
또한 학교별 5,000건 제한은 모든 학교의 합계를 제한하지 않는다. 10개 학교가 같은 외부 프로젝트나 같은 중계 서버를 사용한다면 각 학교의 허용량이 동시에 집중될 수 있다. 이 경우 학교별 정책 위에 중계 서버별·프로젝트별 전체 제한이 필요할 수 있다.
서버가 두 대로 늘어나는 경우도 중요하다. 현재 상태 Map과 Set은 서비스 인스턴스의 메모리에 있다. 두 JVM이 같은 학교를 처리하면 각각 자기 기준으로 5,000건을 허용할 수 있고, 재시작하면 누적량과 휴식 상태가 초기화된다.
여러 인스턴스에서도 같은 제한을 지켜야 한다면 다음 중 어떤 방식으로 학교를 소유할지 먼저 정한다.
- 학교별 담당 인스턴스를 명확히 나누고, 장애 인계 시 상태를 넘기는 방식
- DB나 Redis 등에 학교별 실행권과 제한 상태를 저장하는 방식
- 중계 서버에서 공통 제한을 집행하고 애플리케이션은 그 결과에 따르는 방식
Redis를 사용한다고 자동으로 해결되지는 않는다. 키 생성·증가·만료의 원자성, 잠금 소유권, 만료 후 이전 작업의 계속 실행, 장애 복구를 함께 처리해야 한다. 이 글의 예제는 그 분산 제어까지 구현한 코드가 아니다.
11. 독립 예제로 검증한 것과 남은 검증
실제 3분씩 기다리면서 경계 조건을 테스트하면 검증 시간이 길어지고 실패 원인도 흐려진다. 그래서 제한 로직에 경과 시간 공급자와 대기 함수를 주입할 수 있게 만들었다. 테스트에서는 가상 시간을 전진시키고, 운영용 기본 생성자는 System.nanoTime()과 실제 대기를 사용한다.
가상 시간 검증이 의미하는 것은 정책의 경계 계산이 기대와 맞는지다. 실제 스레드 스케줄링 지연이나 네트워크 응답 시간, DB 커밋 시간을 측정한 결과는 아니다.
함께 제공하는 SchoolPushLimiter.java와 테스트 파일을 OpenJDK 17.0.20에서 컴파일하고 실행했다. 다음 8개 검증이 모두 통과했으며, 180초 휴식은 가상 시간으로 처리했다.
- 서로 다른 목록 호출의 누적: 4,800건 처리 후 500건 입력 시 200건·휴식·200건·100건으로 분할된다.
- 200으로 나눠떨어지지 않는 경계: 4,950건 뒤 250건 입력 시 50건·휴식·200건으로 진행한다.
- 학교별 독립성: A학교를 대기 상태에 유지해도 별도 스레드의 B학교가 처리된다.
- 경계 호출 실패: 5,000건에 도달한 호출이 예외로 끝나도 한도와 휴식이 유지된다.
- 경계 이전 실패: 한도에 못 미친 묶음의 실패도 이미 예약한 건수를 되돌리지 않는다.
- 호출 사이의 시간 경과: 75초가 지난 뒤 호출하면 105초만 기다리고, 휴식이 이미 지났으면 추가 대기가 없다.
- 대기 중 인터럽트: 중단 상태를 복원해 호출자에게 전달하고 휴식 정보를 지우지 않는다.
- 묶음 사이 인터럽트: 전송 함수가 인터럽트 플래그를 세운 채 반환해도 다음 묶음을 계속 보내지 않는다.
예제 디렉터리에서는 다음 명령으로 검증할 수 있다.
mkdir -p out
javac -d out SchoolPushLimiter.java SchoolPushLimiterTest.java
java -cp out SchoolPushLimiterTest
이 작성 환경은 javac 실행 파일 대신 설치된 jdk.compiler 모듈을 호출해 컴파일했다. 일반 JDK 환경에서는 위 명령을 사용하면 되며, 실제 실행 명령과 결과는 예제 README에 함께 남겼다.
로컬에서 재구성한 제한 로직이 통과해도 실제 서비스 검증은 남는다. 특히 다음은 중계 서버·DB가 있는 환경에서 확인해야 한다.
- A학교가 쉬는 동안 B학교가 실제로 진행하는지와 전용 풀의 대기열 길이
- 타임아웃 직후 중계 서버 접수 여부와 같은 메시지 재시도의 중복 처리
- 결과 목록이 비어 있거나 일부만 반환됐을 때의 보존·재시도 정책
- 발송 후 이력 저장에 실패했을 때 대기 행과 이력이 어떤 상태로 남는지
- 삭제되는 대기열에서 조회 순서와 다음 순회가 빠뜨리는 대상을 복구하는지
- 애플리케이션 재시작·작업 취소·다중 인스턴스에서 실행권과 제한 상태가 유지되는지
전송량 계산이 맞는다는 이유로 이 항목까지 정상이라고 결론 내릴 수는 없다. 이번 검증은 통신을 하지 않는 독립 예제의 테스트다.
12. 운영에 적용할 때 남겨야 할 기록
코드를 반영한 뒤 “푸시가 나간다”만 확인하면 정책이 맞게 적용됐는지 알기 어렵다. 전송이 적은 학교에서는 한 번도 5,000건 경계를 만나지 않기 때문에 대기 로직이 잘못돼도 한동안 드러나지 않을 수 있다.
첫 적용은 통제된 테스트 대상으로 시작하고, 입력 수·전송 시도 수·휴식 시작과 재개·실패 처리 수를 함께 기록하는 편이 좋다. 예를 들어 다음은 실제 결과가 아니라 남길 로그의 형태다.
school=A attempted_in_cycle=4800 batch=200
school=A attempted_in_cycle=5000 event=cooldown_started
school=B attempted_in_cycle=600 event=send_started
school=A event=cooldown_completed waited_ms=...
school=A attempted_in_cycle=200 event=send_started
사용자 토큰이나 메시지 본문을 출력하지 않아도 어느 학교가 쉬고 다른 학교가 진행하는지 확인할 수 있다. 필요하면 개인정보와 분리된 내부 추적 ID로 요청과 응답을 연결한다. 공개 자료에는 실제 학교 식별자 대신 A·B처럼 익명화한 값을 사용한다.
운영 지표에서는 최소한 다음을 나눠 본다.
조회 대상 수: 대기열에서 읽은 수다. 예약 미도래·무효 토큰·알림 OFF가 섞일 수 있다.
전송 처리 시도 수: 제한 로직에서 예약한 수다. 실제 외부 접수 수와 정확히 같다고 가정하지 않는다.
중계·제공자 처리 결과: 전체 HTTP 성공과 메시지별 결과를 구분한다. 알림 OFF 처리는 발송 성공에 섞지 않는다.
휴식 중인 학교와 작업 대기열: 의도한 유량 휴식인지, 스레드 부족으로 실행을 못 하는 것인지 구분한다.
재시도 대상과 오래 남은 대상: OFFSET으로 이번 순회에서 건너뛴 행, 예약 대상, 영구 오류, 다음 시각까지 대기 중인 실패를 구분한다.
중단 절차도 함께 준비한다. 작업 중단 신호를 확인하고 인터럽트 상태를 보존하며, 이미 외부에 접수된 요청은 취소됐다고 가정하지 않는다. CompletableFuture.cancel(true)만으로 실행 중 HTTP 호출이나 내부 대기가 반드시 중단된다고 기대해서도 안 된다. 실제 작업과 클라이언트의 취소 계약을 확인해야 한다. Java 17 CompletableFuture 취소 동작
이번 구현에서 얻은 가장 큰 교훈은 대기 시간을 늘리는 것보다 전송 단위와 상태의 수명을 정확하게 정하는 일이 먼저라는 점이었다. DB 페이지 크기와 HTTP 묶음 크기를 나누니 5,000건 경계를 어디에서 계산할지 명확해졌다. 학교별 상태를 분리하니 다른 학교의 대기와 캐시 정리가 서로 영향을 주는 지점도 드러났다.
그리고 유량제어 코드를 붙이는 과정에서 삭제되는 목록의 페이징, 외부 전송 후 DB 실패, 재시도 횟수의 경계처럼 대기 자체와 별개인 문제도 확인했다. 이 문제들을 한꺼번에 “유량제어 완료”로 묶지 않고 남은 과제로 기록해야, 다음 검증과 운영 판단도 정확해진다.